Sur cette page
Mistral Large 4, c'est quoi et que vaut-il ?
Mistral Large 4, surnommé Le Chonk, est le plus gros modèle d'IA de Mistral, la start-up française : 1 050 milliards de paramètres, publié en poids ouverts, avec texte et image en entrée et 1 million de tokens de contexte.
Il fonctionne en Mixture of Experts, comme un hôpital de 128 spécialistes : pour chaque mot, il en appelle 4, plus un généraliste toujours présent. D'où environ 52 milliards de paramètres actifs par mot et une exécution moins coûteuse que sa taille ne le laisse croire. Les 128 doivent pourtant rester en mémoire, ce qui explique le fichier de 1 060,6 Go.
Sa préversion, accessible seulement en ligne, date du 6 octobre 2026. Les poids sont arrivés le 29 octobre 2026, après trois semaines d'apprentissage par renforcement supplémentaires, avec un nouveau réglage de raisonnement sur trois niveaux. Il s'appelle mistral-large-4 dans l'API.
Son niveau : 26 à l'indice v5 d'Artificial Analysis, premier des modèles ouverts développés hors de Chine, d'un point devant Muse Spark Open de Meta. Sept modèles ouverts chinois restent devant, et les meilleurs modèles fermés sont autour de 58. Ses arguments : des poids téléchargeables, une origine européenne et son résultat en agent de code. Sa licence est permissive, mais DeepSeek publie sous MIT, sans sa clause Model-as-a-Service.
Nature et accès de Mistral Large 4
La version Mistral Large 4 du grand modèle de Mistral AI, publiée en poids ouverts, et non l’écosystème Mistral AI ni l’assistant Vibe.
Interfaces : API.
- Accessible via : Mistral AI
Le critère qui compte
Mistral Large 4 n'est pas le meilleur modèle ouvert. Il mène d'un point parmi les modèles ouverts non chinois, devant Muse Spark Open de Meta : son intérêt tient à son origine européenne.
Ce que Mistral Large 4 sait faire
Les capacités qui comptent pour choisir Mistral Large 4 : ce qu'il permet de faire de ses poids, où il marque des points et où il en perd.
Poids ouverts sans formulaire
Le dépôt Hugging Face s'ouvre sans demande d'accès. Vous pouvez héberger le modèle, le réentraîner sur vos données et l'intégrer à un produit vendu. C'est le changement net depuis la préversion, qui n'existait qu'en ligne et sans licence connue.
Agents de code
Dans Mistral Vibe, le modèle obtient 48 au classement des agents de code d'Artificial Analysis, à côté de GLM-5.3 dans OpenCode (49) et devant DeepSeek V4.1 Flash dans Harness (46). Il y consomme 8,5 millions de tokens par tâche, contre 15,9 et 16,7 millions.
Raisonnement sur trois niveaux
Faible, moyen ou élevé, avec élevé par défaut. Le niveau moyen écrit environ un tiers de tokens en moins pour environ 3 points de moins à l'indice, d'après le graphique d'Artificial Analysis : un réglage utile quand l'addition compte plus que le dernier point.
1 million de tokens de contexte
Soit environ 1 500 pages A4 selon Artificial Analysis. Un petit modèle trieur choisit 2 048 morceaux du contexte et le modèle ne relit que ceux-là, d'après vLLM, pour avaler de longs documents sans faire exploser la mémoire. Cela concerne le modèle complet servi sur serveur.
Texte et image en entrée
Mistral Large 4 lit du texte et des images, avec appels de fonctions, sorties structurées et traitement par lots dans l'API. Il sert donc à analyser un document scanné ou une capture, puis à appeler vos outils à partir du résultat.
Moins de réponses inventées
Sur l'épreuve AA-Omniscience, il invente dans 28 % des cas où il ne sait pas, contre 41 % pour la préversion. Il ne sait pas plus de choses pour autant : 26 % de bonnes réponses sur ces questions pointues, contre 40 % pour DeepSeek.
Cybersécurité
Son indice cyber de 51 le place troisième des modèles ouverts, derrière DeepSeek (57) et MiMo (56). Mistral mesure 96,6 % de refus sur les demandes malveillantes et reconnaît un risque d'aide à de vraies attaques. La variante spécialisée reste réservée à des partenaires contrôlés, comme Orange Cyberdefense.
Entraînement et origine européens
Mistral annonce 3 800 GPU Nvidia et un entraînement sur infrastructure européenne. Son patron, Arthur Mensch, défend l'idée qu'il est faux de croire que l'Europe peut dépendre des modèles ouverts chinois : ceux qui fabriquent la technologie peuvent un jour couper l'accès.
Mistral Large 4 en local : quelle version sur quelle machine, à quel prix
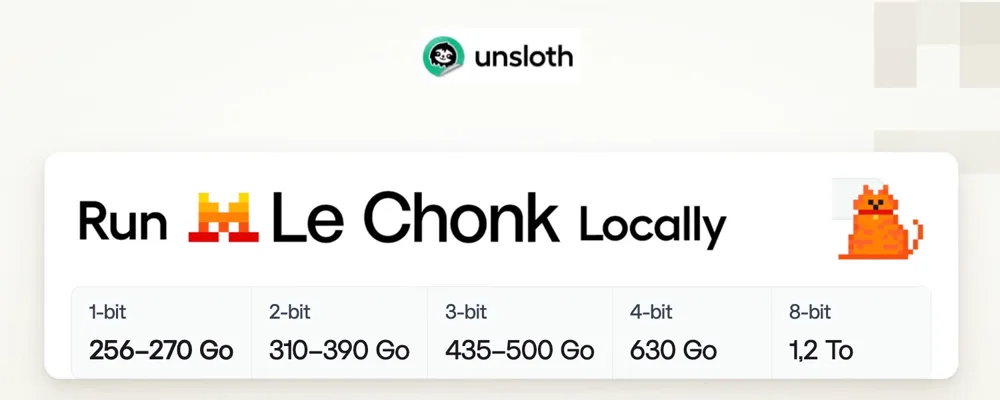
Pour faire tourner Mistral Large 4 chez vous, il faut au minimum 256 Go de mémoire, et vous n’aurez alors qu’une version compressée. La version complète pèse 1 060,6 Go et l’exemple de service officiel utilise 8 GPU. Mistral, vLLM et Unsloth publient ces chiffres séparément : les voici réunis.
| Version | Poids et mémoire | Fidélité* | Machine et prix |
|---|---|---|---|
Unsloth 1 bit UD-IQ1_S | 233 Go, 256–270 Go de mémoire | 90,6 % | Mac Studio M5 Ultra 256 Go / 1 To : 10 999 € (Apple Store France, 30 octobre 2026), ou 2 DGX Spark selon Unsloth |
Unsloth 2 bits UD-IQ2_XXS | 302 Go, 310–390 Go de mémoire | 93,9 % | Station ou serveur, prix non relevé |
Unsloth 2 bits UD-Q2_K_XL | 378 Go, 310–390 Go de mémoire | 95,6 % | Station ou serveur, prix non relevé |
Unsloth 3 bits UD-Q3_K_XL | 493 Go, 435–500 Go de mémoire | 96,6 % | Station ou serveur, prix non relevé |
Unsloth 4 bits UD-Q4_K_XL | 605 Go, 630 Go de mémoire | 97,8 % | Serveur, prix non relevé |
Unsloth 8 bits UD-Q8_K_XL | 1 115 Go, 1,2 To de mémoire | Non publiée | Serveur, prix non relevé |
| Complète, sous vLLM | 1 060,6 Go, selon le contexte | Référence | 8 GPU Nvidia haut de gamme : centaines de milliers d’euros (ordre de grandeur, sans devis) |
*« Top-1 agreement » chez Unsloth : la part des cas où la version compressée choisit le même mot suivant que l’original. Unsloth ne détaille pas sa mesure. La mémoire additionne RAM et VRAM : un serveur à 256 Go de RAM peut charger le fichier, sans garantie de vitesse. Mistral et vLLM prévoient aussi des versions NVFP4 sur 4 GPU Nvidia Blackwell et MXFP4 sur 4 GPU AMD MI350.
Quatre points changent la décision :
- Le Mac Studio n’a presque aucune marge. 233 Go de fichier dans 256 Go de mémoire laissent 23 Go au système et au contexte. Unsloth écrit que le modèle « should fit », et son exemple limite le contexte à 32 768 tokens, loin du million annoncé pour le modèle complet.
- Aucun débit local mesuré n’a été trouvé. La page d’Unsloth ne donne aucun chiffre, et cette fiche n’en a pas mesuré. Pour situer, l’API de Mistral atteint 161 tokens par seconde selon Artificial Analysis.
- 90,6 % par mot n’est pas 90,6 % de qualité. Un mot différent influence le suivant, et les écarts s’additionnent sur un long raisonnement. Tous les scores de cette page concernent le modèle servi par l’API, pas la version compressée.
- Le délai pèse aussi. Le 30 octobre 2026, Apple annonçait 13 à 15 semaines de livraison pour cette configuration, ou 345,48 € par mois sur 36 mois.
Machine ou API ? En comptant 1 € pour 1 $, à ajuster selon le taux du jour et hors taxes, 10 999 € paient environ 5 300 tâches de l’indice d’Artificial Analysis, avec le modèle complet. Une tâche d’agent de code peut consommer bien plus : 8,5 millions de tokens en moyenne sur son classement. La machine se justifie surtout par une contrainte : un cabinet d’avocats, un hôpital ou une PME dont les données ne doivent pas sortir des murs. Pour un modèle plus léger sur une machine ordinaire, passez par notre guide de l’IA locale.
Télécharger Mistral Large 4 : Hugging Face, GGUF et commande
Modèle complet. Les poids sont sur Hugging Face, dépôt Mistral-Large-4-1T-A52B, sans formulaire : 54 fichiers, poids quantifiés en FP8. Mistral recommande vLLM ou SGLang, avec un exemple sur 8 GPU.
Version compressée. Les fichiers GGUF sont chez Unsloth. Cette commande reprend l’exemple d’Unsloth, adapté à la plus petite version :
./llama.cpp/build/bin/llama-server \
    -hf unsloth/Mistral-Large-4-1T-A52B-GGUF:UD-IQ1_S \
    --ctx-size 32768 \
    --temp 1.0 --top-p 0.95 --top-k 0 --min-p 0.0 \
    --chat-template-kwargs '{"reasoning_effort":"high"}' \
    --host 127.0.0.1 --port 8080
-hf lance un téléchargement de 233 Go. Il faut une version de llama.cpp qui prend en charge le modèle, sans numéro minimal publié par Unsloth ; sa documentation donne la compilation, avec -DGGML_CUDA=OFF sur Mac. Le serveur s’ouvre sur http://127.0.0.1:8080. Cette commande n’a pas été exécutée pour cette fiche.
Ollama. Le 30 octobre 2026, sa page n’affichait que le tag mistral-large-4:cloud, qui tourne sur des serveurs distants. Sur GitHub, aucun dépôt officiel des poids n’a été trouvé : la référence est Hugging Face.
Mistral Large 4 benchmark : préversion, version finale et modèles chinois
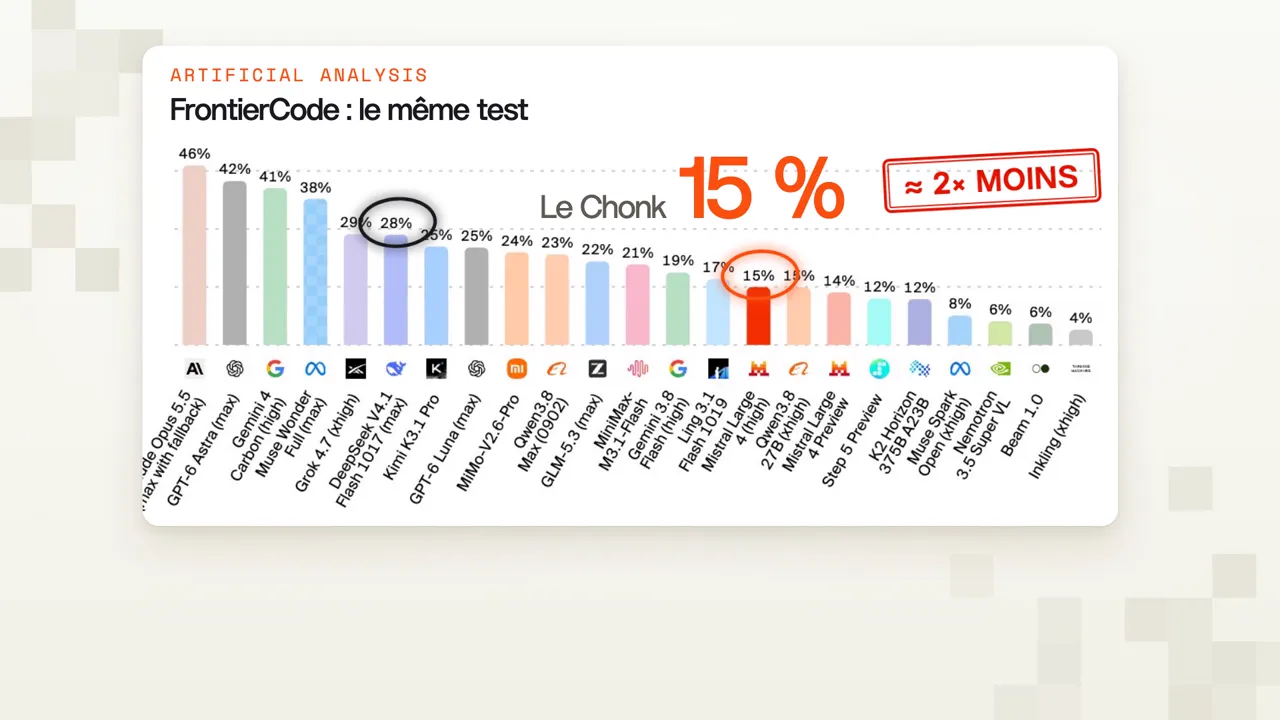
La version finale gagne un point sur la préversion et coûte moins cher, mais DeepSeek, GLM et MiMo restent devant à l’indice général et sur FrontierCode. GPT-6 Luna, fermé, sert de repère de prix.
De la préversion à la version finale (Artificial Analysis, relevé le 30 octobre 2026) :
| Mesure | Préversion | Version finale |
|---|---|---|
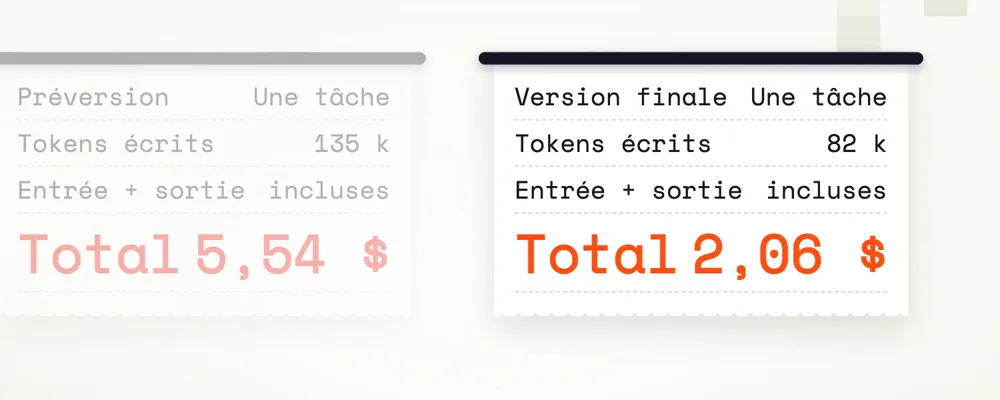
| Indice d’intelligence v5 | 25 | 26 |
| FrontierCode 2.0 | 13,6 % | 15,0 % |
| Terminal-Bench 4.0 | 26,8 % | 24,7 % |
| Réponses inventées (AA-Omniscience) | 41 % | 28 % |
| Tokens écrits par tâche | 135 k | 82 k |
| Prix par M tokens (entrée / sortie) | 1,36 $ / 4,18 $ à l’origine | 0,70 $ / 2,10 $ |
| Coût par tâche de l’indice | 5,54 $* | 2,06 $ |
| Poids téléchargeables | Non | Oui |
*Chiffre publié par Artificial Analysis à la sortie. Sa page de la préversion affiche maintenant 4,21 $, sans explication de l’écart : la baisse est de 63 % sur le premier chiffre, de 51 % sur le second.
Face aux modèles chinois, avec GPT-6 Luna comme repère :
| Mesure | Mistral Large 4 | DeepSeek V4.1 Flash | GLM-5.3 | MiMo-V2.6-Pro | GPT-6 Luna |
|---|---|---|---|---|---|
| Indice v5 | 26 | 32 | 32 | 30 | 28 |
| FrontierCode 2.0 | 15,0 % | 28,5 % | 21,6 % | 24,0 % | 25,2 % |
| Terminal-Bench 4.0 | 24,7 % | 33,8 % | 41,9 % | 34,8 % | 12,6 % |
| Agents de code | 48 | 46 | 49 | n. r. | n. r. |
| Tokens par tâche d’agent | 8,5 M | 16,7 M | 15,9 M | n. r. | n. r. |
| Indice cyber | 51 | 57 | n. r. | 56 | n. r. |
| Prix entrée / sortie | 0,70 / 2,10 $ | 0,30 / 1,20 $ | 1,40 / 4,40 $ | 0,435 / 0,87 $ | 0,10 / 0,50 $ |
| Coût par tâche | 2,06 $ | 0,60 $ | 5,01 $ | 0,26 $ | 0,15 $ |
| Poids ouverts | Oui | Oui | Oui | Oui | Non |
DeepSeek V4.1 Flash 1017. n. r. : non relevé. Les 7 modèles ouverts mieux notés écrivent de 113 k à 225 k tokens par tâche de l’indice, sans détail par modèle.
Trois lectures que les annonces ne donnent pas :
- Le prix par token ne suffit pas. GLM-5.3 coûte 2,4 fois plus cher par tâche : un tarif deux fois plus élevé, et le reste vient de ce qu’il consomme. La sortie seule n’explique pas tout : 82 k tokens à 2,10 $ font 0,17 $ sur les 2,06 $, et Artificial Analysis ne détaille pas le reste.
- Terminal-Bench ne confirme pas le bond annoncé. Mistral annonce 28 puis 41 %. La mesure indépendante donne 26,8 puis 24,7 %. Les conditions peuvent différer et 2 points ne prouvent pas un recul, mais le bond n’y est pas. Le modèle fait quand même deux fois mieux que GPT-6 Luna sur cette épreuve.
- Le mode moyen existe pour l’addition. Lu sur le graphique d’Artificial Analysis, à un point près : environ 23 à l’indice et 56 k tokens par tâche, contre 26 et 82 k en mode élevé.
Avis sur Mistral Large 4 : les 4 reproches à la préversion revérifiés un par un
Le bilan : un reproche corrigé, un à moitié, deux qui tiennent. Il confronte les annonces de Mistral aux mesures indépendantes, sans essai sur un projet réel.
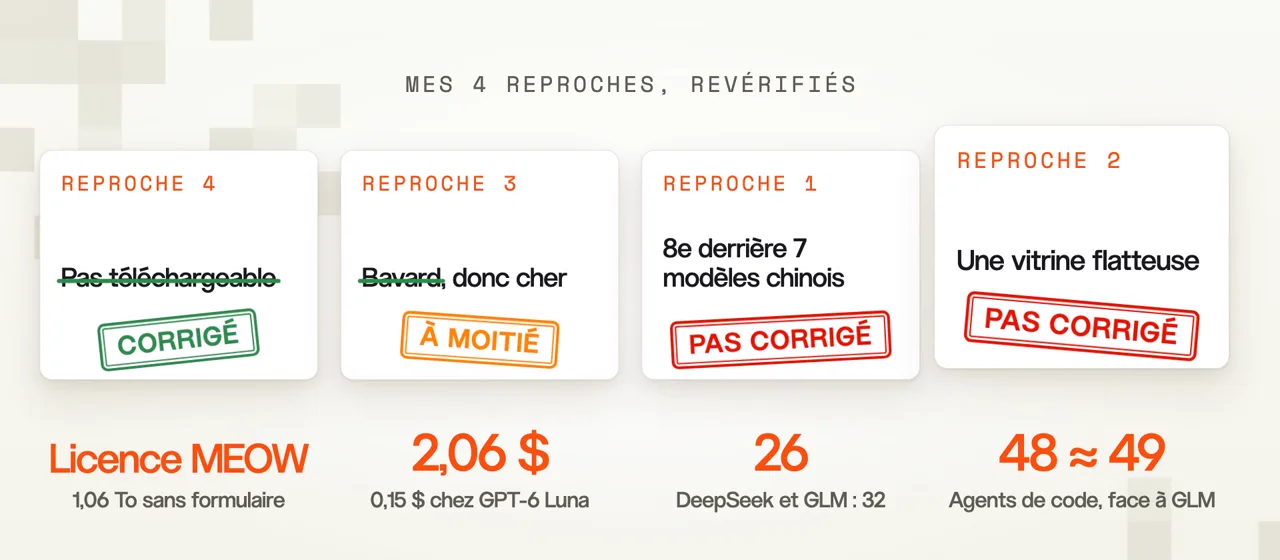
1. Derrière sept modèles chinois : pas corrigé. La préversion affichait 38, la version finale 26, mais elle n’a pas reculé : Artificial Analysis a durci son barème. Sur le barème v5, c’est 25 puis 26. Sept modèles ouverts restent devant, tous chinois, et Gemini 4 Carbon, Claude Opus 5.5 et GPT-6 Astra sont autour de 58. La formule de Mistral reste exacte, « the highest among western open-weight models », mais son avance sur Muse Spark Open, de Meta, tient à un point.
2. Des chiffres flatteurs : toujours là. Mistral se présente premier des modèles ouverts sur FrontierCode 2.0, le test de programmation de Cognition : 19,7 %, devant DeepSeek à 19,3 %. Sur le même test, Artificial Analysis mesure 15,0 % pour Mistral et 28,5 % pour DeepSeek V4.1 Flash 1017. L’écart peut venir des outils, du temps laissé, du réglage du concurrent. Artificial Analysis publie sa méthode : 132 tâches, trois lancements chacune, 500 tours au maximum. On ne connaît pas toutes les conditions du test de Mistral.
3. Bavard, donc cher : à moitié corrigé. Il écrit 39 % de tokens en moins, et le tarif promotionnel du lancement est devenu le prix normal. Le coût par tâche passe de 5,54 $ à 2,06 $, sans qu’on puisse répartir la baisse entre tarif et consommation : Artificial Analysis publie deux points de départ différents. GPT-6 Luna fait pourtant 28 pour 0,15 $ la tâche, près de 14 fois moins, et DeepSeek 32 pour 0,60 $, 3,4 fois moins.
4. Pas téléchargeable, licence inconnue : corrigé. Les poids sont publics et la licence est lisible. Mistral a aussi ajouté trois semaines d’apprentissage par renforcement à la préversion, dont il écrivait qu’elle n’avait pas fini son entraînement.
La vidéo sur la préversion, du 7 octobre 2026, où ces quatre reproches sont posés :
Licence MEOW de Mistral Large 4 : ce qui est permis
La licence de Mistral Large 4 permet tout usage, y compris commercial, sauf vendre de l’accès au modèle sans contrat. Mistral la présente comme une MIT modifiée.
| Vous voulez… | Permis ? |
|---|---|
| L’utiliser en interne, quelle que soit la taille de l’entreprise | Oui |
| Le modifier ou le réentraîner sur vos données | Oui |
| L’intégrer à une fonction de votre logiciel et vendre ce logiciel | Oui |
| Relayer des requêtes vers un modèle hébergé ailleurs | Oui |
| Donner à des tiers un accès au modèle avec un vrai contrôle sur les entrées, les paramètres ou l’entraînement | Licence commerciale obligatoire |
Le point à lire de près, dans le texte de la licence : si vous ou l’une de vos sociétés affiliées exploitez une activité de Model-as-a-Service, il faut un contrat avec Mistral avant d’utiliser le modèle. L’usage interne et l’usage via les produits officiels de Mistral restent exclus. Le mot « affiliates » n’y est pas défini et aucun seuil de chiffre d’affaires ne figure. Gardez aussi la mention « 2026 - Mistral ». Un groupe qui possède un hébergeur doit faire relire ce point : ceci n’est pas un avis juridique.
Autre point réglementaire : un chercheur de Mistral annonce 10^25 opérations de calcul pour l’entraînement. C’est pile le seuil de l’article 51 de l’AI Act, au-delà duquel un modèle est présumé à risque systémique, avec des obligations pour son fournisseur.
Pour qui est fait Mistral Large 4 ?
Mistral Large 4 répond d'abord à des contraintes d'origine, de licence et d'hébergement, plus qu'à une recherche du meilleur score.
Particulièrement adapté
- Entreprises, cabinets ou hôpitaux dont les données ne doivent pas sortir de leurs machines
- Équipes qui font tourner des agents de code et trouvent GLM-5.3 trop cher
- Éditeurs européens qui veulent intégrer un modèle ouvert à un produit vendu
Moins adapté
- Particuliers sans 256 Go de mémoire : l'API ou un modèle plus léger conviennent mieux
- Budgets serrés : DeepSeek V4.1 Flash fait mieux pour 3,4 fois moins cher
- Code le plus difficile : Claude Opus 5.5 et GPT-6 Astra restent loin devant
La version compressée n'est pas celle des scores publiés. Si vous achetez une machine pour elle, comptez sur votre propre évaluation plutôt que sur ces classements.
En bref
Les points forts et limites de Mistral Large 4
Ce qu’on aime
- Licence permissive, sans seuil de chiffre d’affaires
- Quasi-égalité avec GLM-5.3 en agent de code, avec moins de tokens
- Hallucinations en nette baisse sur la préversion
Ce qui peut frustrer
- 6 points derrière les meilleurs modèles ouverts chinois
- 3,4 fois plus cher que DeepSeek par tâche
- Local réservé aux machines à 256 Go de mémoire ou plus
Quel est le prix de Mistral Large 4 ?
L'API de Mistral Large 4 coûte 0,70 $ par million de tokens en entrée et 2,10 $ en sortie, moitié moins que le tarif d'origine de la préversion. Les poids sont gratuits, mais pas la machine.
API à l’usageNotre choix0,70 $ en entrée, 2,10 $ en sortie, par million de tokens+
Texte, images et raisonnement, sans abonnement.
Facturation : À l’usage
API — entrée en cache0,07 $ / million de tokens+
Contexte réutilisé d’un appel à l’autre.
Facturation : À l’usage
Poids en localGratuit, hors machine+
Téléchargement sur Hugging Face.
Facturation : Selon votre machine
Sur les épreuves d'Artificial Analysis, cela représente 2,06 $ par tâche. Prix hors taxes, facturés en dollars par Mistral.
Vibe Pro coûte 14,99 $ HT par mois et inclut 15 $ de crédits API par mois d'après Mistral, qui n'indique pas sur cette page quels modèles chaque formule inclut.
Quelles alternatives à Mistral Large 4 choisir ?
DeepSeek gagne sur le score et le prix, GLM-5.3 sur Terminal-Bench, Claude sur le code difficile ; Mistral Large 4 garde l'avantage de l'origine européenne.
Mistral Large 4 face à DeepSeek, GLM et Claude
Mesures d'Artificial Analysis, relevées le 30 octobre 2026.
| Outil | Indice v5 | FrontierCode 2.0 | Coût par tâche | Licence |
|---|---|---|---|---|
| Mistral Large 4 | 26 | 15,0 % | 2,06 $ | MEOW |
| DeepSeek V4.1 Flash 1017 | 32 | 28,5 % | 0,60 $ | MIT |
| GLM-5.3 | 32 | 21,6 % | 5,01 $ | Licence GLM, avec restrictions |
| Claude Opus 5.5 | 58 | 46,4 % | 10,04 $ | Propriétaire |
Modèle à poids ouverts
Mistral Large 4 est-il le bon choix pour vous ?
Testez vos propres prompts par l'API, payante, ou voyez ses capacités dans les démos Hugging Face, avant d'acheter une machine.
À savoir : Le téléchargement est gratuit, l'API est payante, et le local demande au moins 256 Go de mémoire.
FAQ sur Mistral Large 4
Mistral Large 4, c'est quoi ?
C'est le plus gros modèle d'IA de Mistral, surnommé Le Chonk : 1 050 milliards de paramètres, poids ouverts, texte et image en entrée, 1 million de tokens de contexte. Sa préversion date du 6 octobre 2026, ses poids du 29 octobre.
Mistral Large 4 est-il gratuit ?
Le téléchargement est gratuit et sans formulaire, mais il faut la machine. L'API est payante : 0,70 $ par million de tokens en entrée, 2,10 $ en sortie. Hugging Face annonce des démos avec un petit budget gratuit la première semaine, soit jusque vers le 5 novembre 2026 si l'on compte depuis la sortie.
Mistral Large 4 est-il open source ?
Ses poids sont ouverts, sous une licence MEOW que Mistral présente comme une MIT modifiée. Vous pouvez l'utiliser, le modifier et le vendre dans un produit. Une activité de Model-as-a-Service demande un contrat, sauf pour un usage interne. Ce n'est donc pas une licence sans condition.
Quelle RAM pour Mistral Large 4 ?
D'après Unsloth : 256 à 270 Go en 1 bit, 310 à 390 Go en 2 bits, 435 à 500 Go en 3 bits, 630 Go en 4 bits et 1,2 To en 8 bits. C'est le total RAM et VRAM, ou la mémoire unifiée d'un Mac. Gardez de la marge pour le système et le contexte.
Peut-on utiliser Mistral Large 4 avec Ollama ?
Pas de tag local officiel à ce jour : le 30 octobre 2026, la page Ollama n'affichait que le tag mistral-large-4:cloud, sur serveurs distants. Pour le lancer chez vous, utilisez les fichiers GGUF d'Unsloth avec llama.cpp.
Mistral Large 4 est-il disponible dans Vibe ?
Mistral annonce le modèle dans Mistral Vibe Code et son outil en ligne de commande, Mistral Vibe. Pour l'assistant grand public, aucune annonce n'a été trouvée. Sa page de prix n'indique pas quels modèles chaque formule inclut.
Mistral Large 4 ou Claude Opus 5.5 ?
Pour le code difficile, Claude Opus 5.5 reste loin devant : 58 contre 26 à l'indice, 46,4 % contre 15,0 % sur FrontierCode 2.0. Il coûte aussi 10,04 $ par tâche contre 2,06 $. Mistral Large 4 offre ce qu'Opus n'a pas : des poids utilisables sur vos machines.
Mistral Large 4 vs DeepSeek : lequel choisir ?
DeepSeek V4.1 Flash 1017 gagne sur le score et le prix : 32 contre 26, 28,5 % contre 15,0 % sur FrontierCode 2.0, 0,60 $ contre 2,06 $ par tâche. Mistral passe devant en agent de code (48 contre 46), et reste le choix pour un modèle européen.